Sam Audio
SAM Audio nutzt KI, um eine nahtlose Audio-Trennung zu ermöglichen, was es ideal für Musikproduktion, Podcasting und Sounddesign macht.
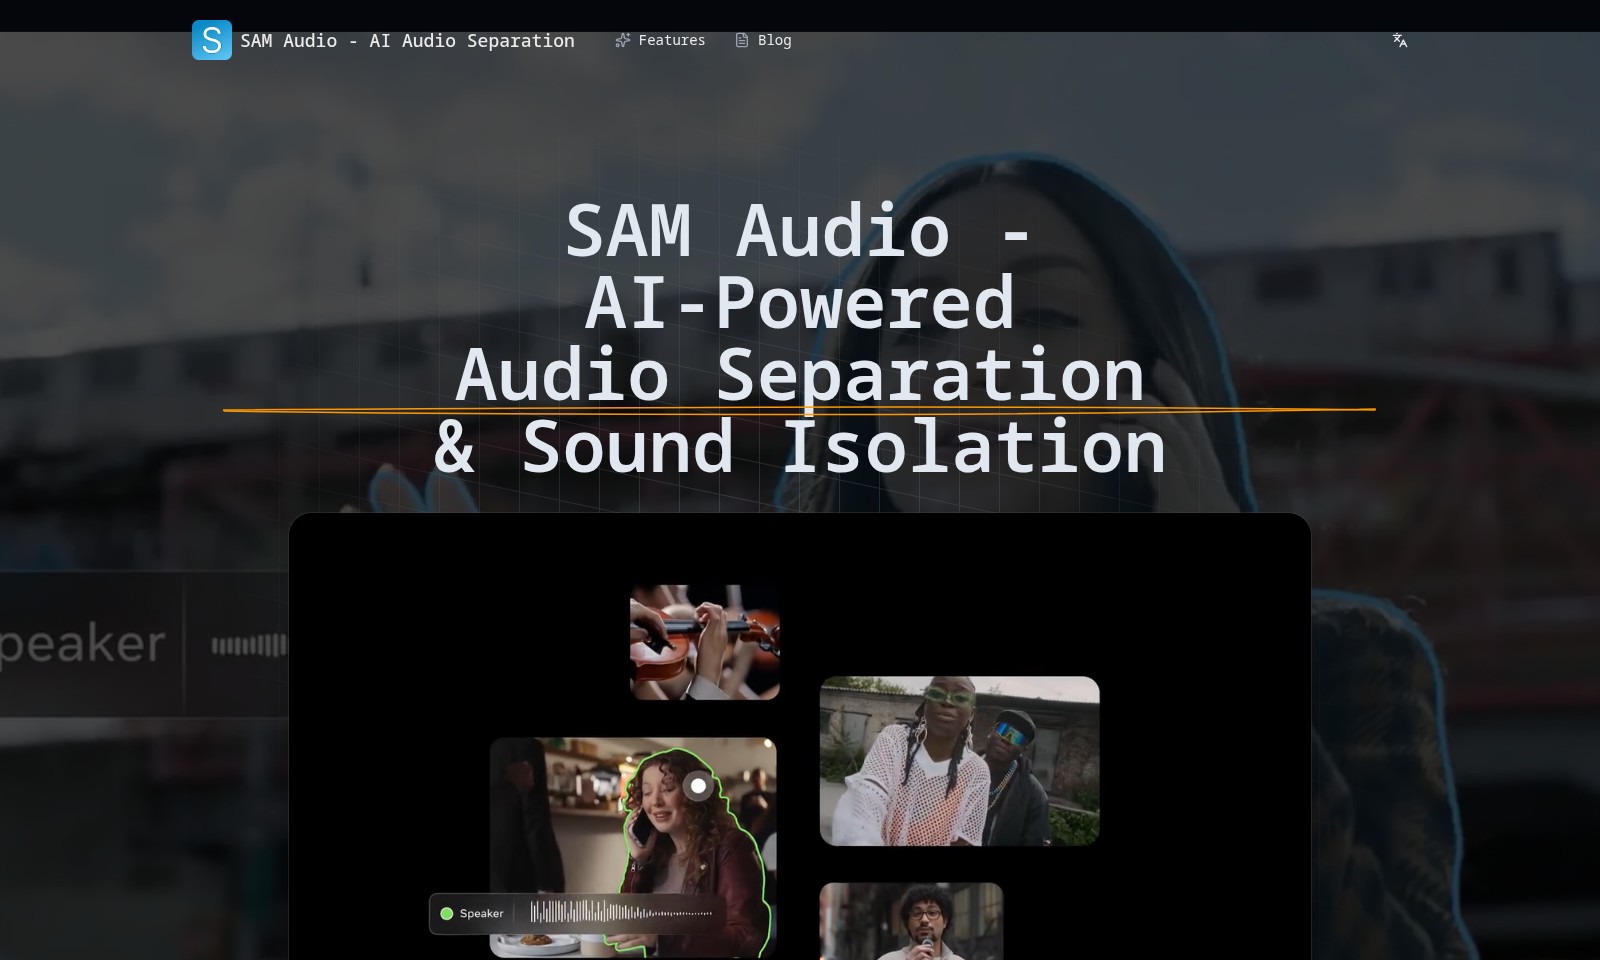
Sam Audio Einführung
SAM Audio - AI-gesteuerte Audio-Trennung
SAM Audio bringt den Segment Anything Audio Model von Meta in Ihren Arbeitsablauf. Mit dieser innovative Technologie können Sie Gesang, Instrumente, Sprache und Soundeffekte aus komplexen Audio-Mischungen isolieren, indem Sie textbasierte, visuelle oder zeitbasierte Eingabeaufforderungen nutzen. Diese Plattform ermöglicht es Audioprofis, präzise Trennungen vorzunehmen, die sowohl die Qualität als auch die Kreativität in der Audioproduktion erheblich steigern. Da SAM Audio eine unabhängige KI-Dienstleistung ist, nutzen wir unsere eigene Infrastruktur, um Apache-2.0-lizenzierte Modelle bereitzustellen und zu optimieren. Unser Ziel ist es, Ihnen eine benutzerfreundliche und leistungsstarke Lösung anzubieten, die für alle Ihre Audio-Trennungsbedarfe geeignet ist.
Sam Audio Funktionen
Funktionen von SAM Audio
Echtzeit-Vocaltrennung - Überlegene Klangqualität Mit SAM Audio können Benutzer Gesang in Echtzeit von komplexen Audio-Mischungen trennen, was eine unvergleichliche Klangqualität für Musikproduktionen und Podcasts bietet. Die Technologie nutzt fortschrittliche KI-Modelle, um hochgradig präzise Trennungen zu gewährleisten.
Instrumentenisolierung - Mehr Ausdrucksmöglichkeiten Die präzise Isolierung von Instrumenten ermöglicht es Produzenten, jeden Klang klar herauszuarbeiten und ihre kreativen Möglichkeiten zu erweitern. Durch den Einsatz der Segment Anything Audio Model (SAAM) von Meta bietet SAM Audio eine nahtlose Trennung, die mühelos in bestehende Workflows integriert werden kann.
Sprachtrennung - Verbesserte Hörverständlichkeit Ideal für den Einsatz in Filmen und Podcasts, verbessert die Sprachtrennung von SAM Audio die Verständlichkeit erheblich. Nutzer können Dialoge klar vom Hintergrund entfernen und somit die Qualität ihrer Audio-Inhalte steigern.
Soundeffekt-Isolierung - Präzise Kontrolle Die Trennung von Soundeffekten bietet Ihnen die Möglichkeit, kreative Steuerelemente über jedes Element Ihres Audio-Mixes zu haben. Benutzer können spezifische Effekte isolieren und anpassen, um ihre Produktionen zu verbessern.
Benutzerfreundliche Schnittstelle - Effizientes Arbeiten Die benutzerfreundliche Oberfläche von SAM Audio ermöglicht es auch Anfängern, die leistungsstarken Funktionen mühelos zu nutzen. Einfacher Zugriff auf Funktionen führt zu schnelleren Bearbeitungen und höherem kreativen Output.
Optimierte Leistung - Schnelle Verarbeitung Dank der Optimierung auf einer eigenen Infrastruktur bietet SAM Audio eine beschleunigte Prozessgeschwindigkeit, die Nutzer in ihrem Workflow unterstützt. Diese Effizienz steigert die Produktivität und minimiert Wartezeiten bei der Audioverarbeitung.
Unabhängiger KI-Service - Flexibilität und Kontrolle Als unabhängiger Dienstleister gibt SAM Audio den Benutzern die volle Kontrolle über ihre Audio-Projekte, ohne von externen Anbietern abhängig zu sein. Diese Unabhängigkeit stellt sicher, dass die Nutzer stets die beste Leistung und Qualität erhalten.
Häufig gestellte Fragen zu Sam Audio
{ "markdown1": "### Häufig gestellte Fragen zu SAM Audio\n\nWas ist SAM Audio und wie funktioniert es?\nSAM Audio ist ein KI-gestütztes Audio-Trennungswerkzeug, das das Segment Anything Audio Model von Meta nutzt. Damit können Benutzer Gesang, Instrumente und andere Klänge aus komplexen Audiomischungen isolieren, indem sie Text-, Bild- oder zeitbasierte Eingaben verwenden.\n\nWelche Funktionen bietet SAM Audio?\nSAM Audio ermöglicht eine präzise Trennung von Audioinhalten und hilft Benutzern, spezifische Klänge zu extrahieren. Die Software ist besonders nützlich für Musikproduzenten, Podcaster und Content Creator, die klare und getrennte Audioquellen benötigen.\n\nWie gehe ich mit Fehlern in SAM Audio um?\nFalls SAM Audio nicht wie erwartet funktioniert, können häufige Probleme wie CUDA-Fehler, FFmpeg-Probleme oder sogar langsame Inferenz auftreten. Unsere Blogbeiträge bieten Lösungen und Schritt-für-Schritt-Anleitungen zur Behebung dieser häufigen Fehler.\n\nBenötige ich spezielle Hardware für SAM Audio?\nJa, um die besten Ergebnisse zu erzielen, sollten Benutzer über eine GPU mit ausreichendem VRAM verfügen. In unserem Blog finden Sie umfass
Wie man Sam Audio verwendet
Benutzerregistrierung
Registrieren Sie sich auf der Website, indem Sie auf die Schaltfläche 'Registrieren' klicken. Füllen Sie das Anmeldeformular mit Ihren persönlichen Daten aus und bestätigen Sie Ihre E-Mail-Adresse durch den Link, den wir Ihnen zusenden.
Profil einrichten
Nachdem Sie sich registriert haben, loggen Sie sich in Ihr Konto ein. Besuchen Sie die Einstellungen, um Ihr Profil zu vervollständigen. Fügen Sie ein Profilbild hinzu und geben Sie zusätzliche Informationen zu Ihren Audio-Präferenzen an.
Erste Schritte mit SAM Audio
Navigieren Sie zu den Hauptfunktionen von SAM Audio. Beginnen Sie mit dem Hochladen Ihrer Audiodateien, um mit der Trennung von Stimmen, Instrumenten und anderen Klängen zu experimentieren. Nutzen Sie das Echtzeit-Vorschau-Feature, um sofortige Ergebnisse zu sehen.
Nutzung der Hauptfunktionen
Probieren Sie die verschiedenen Trennungstechniken aus. Sie können Text, visuelle oder zeitbasierte Eingabeaufforderungen verwenden, um den gewünschten Klang zu isolieren. Nutzen Sie unser integriertes Wiki für spezifische Anleitungen zu den Trennfunktionen.
Probleme beheben
Wenn Sie auf Schwierigkeiten stoßen, sehen Sie sich unsere FAQ-Sektion an. Hier finden Sie Lösungen für häufige Probleme wie CUDA-Fehler oder langsame Verarbeitung. Zögern Sie nicht, unseren Support zu kontaktieren, wenn Sie weitere Hilfe benötigen.
Bewertungen
Vorteile
- Einfach zu bedienen
- Schnelle Verarbeitung
- Hervorragende Ergebnisse
- Erschwinglicher Preis
Nachteile
- Eingeschränkte kostenlose Version
- Benötigt Internetverbindung
Kommentare
Noch keine Kommentare. Seien Sie der Erste, der seine Gedanken teilt!
Sam Audio - Alternative Plattformen
Für einige Alternativen zu Sam Audio, die Sie möglicherweise benötigen, bieten wir Ihnen nach Funktionen unterteilte Websites an.

Voicemaker verwandelt Text in menschenähnliche Sprache und ermöglicht es Creators, einfach Sprachübertragungen für verschiedene Anwendungen zu erstellen.
Diese Webseite bietet einen kostenlosen Online-Audiokonverter, der über 300 Formate unterstützt und es den Nutzern ermöglicht, Audio aus Videodateien sicher zu konvertieren und zu extrahieren.
Adobe Podcast bietet KI-gesteuerte Tools für die nahtlose Aufnahme, Bearbeitung und Verbesserung von Audio online.
TurboScribe bietet unbegrenzte Audio- und Video-Transkription mit fortschrittlichen Funktionen wie Sprechererkennung, Übersetzungen und hoher Genauigkeit.