Sam Audio
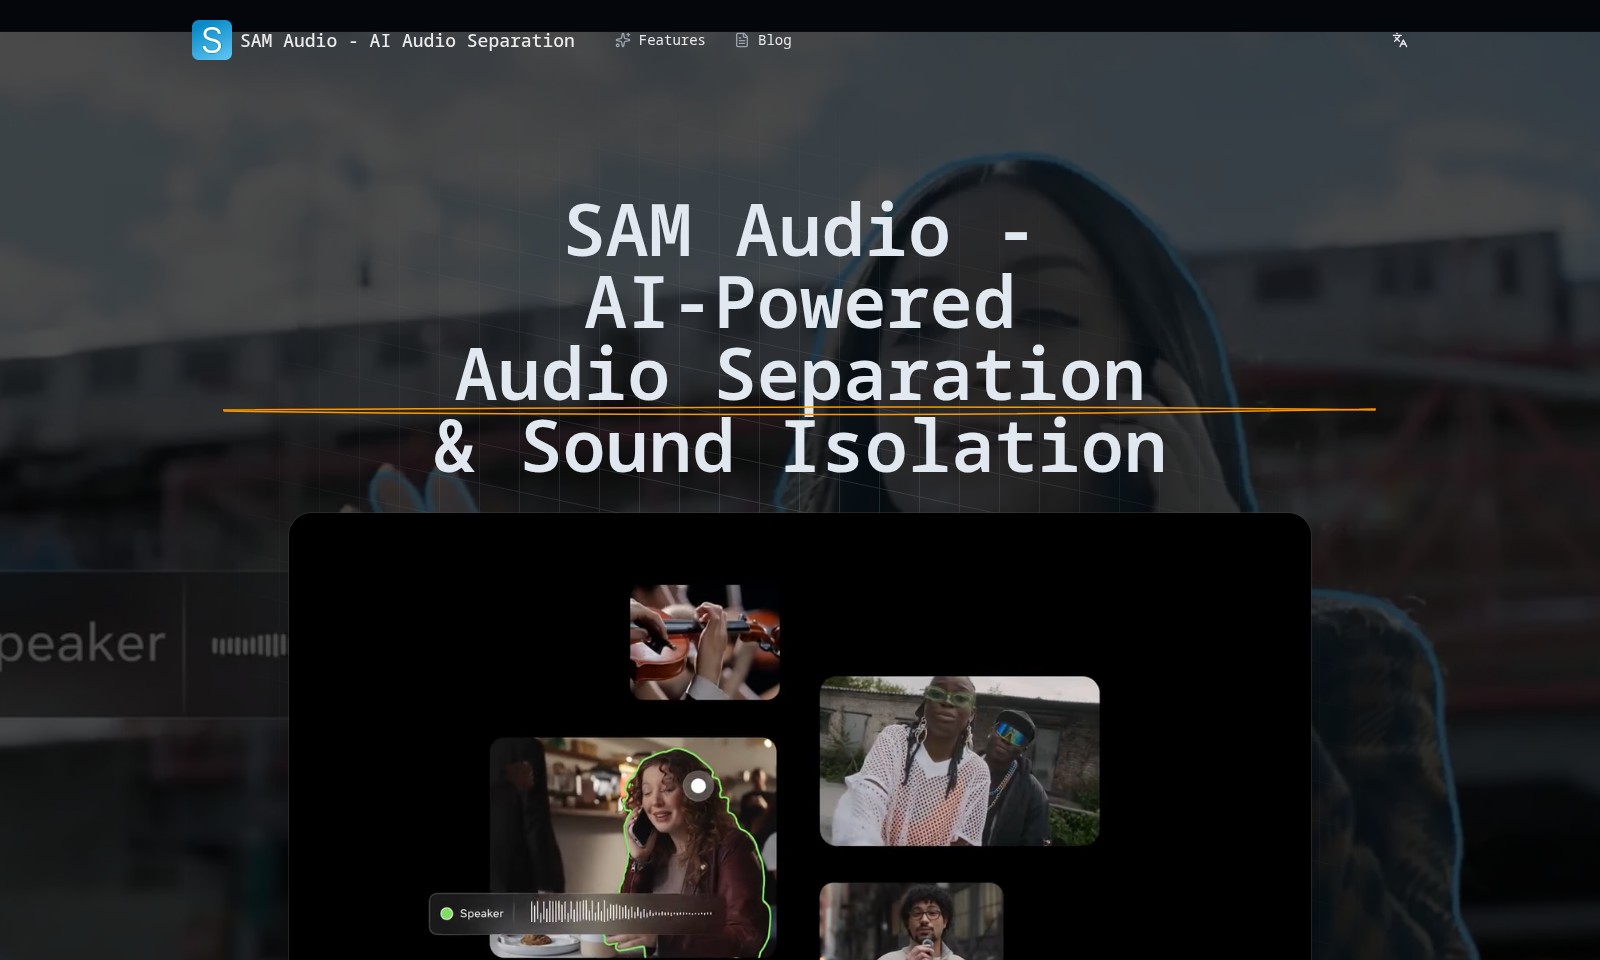
SAM Audio utiliza inteligencia artificial para ofrecer una separación de audio fluida, lo que lo hace ideal para la producción musical, la creación de podcasts y el diseño de sonido.
Sam Audio Introducción
SAM Audio - Separación de Audio AI
SAM Audio transforma tu flujo de trabajo con el modelo Segment Anything de Meta, permitiendo la separación de voces, instrumentos, discursos y efectos de sonido de mezclas de audio complejas mediante comandos de texto, visuales o temporales.
:Sam Audio Características
Separación de Audio - Aislamiento Preciso de Sonido
La separación de audio permite aislar voces, instrumentos y efectos de sonido de mezclas complejas, mejorando la calidad del audio en sus proyectos. Utilizamos el modelo Segment Anything Audio de Meta para ofrecer una calidad superior en la separación de audio.
Prompts Versátiles - Flexibilidad en la Aislamiento
Nuestra herramienta admite prompts de texto, visuales o basados en el tiempo, lo que le permite especificar exactamente qué quiere separar en su mezcla. Esto facilita la personalización del proceso y se adapta a sus necesidades específicas.
Infraestructura Propia - Eficiencia en el Desempeño
Al implementar modelos con licencia Apache-2.0 en nuestra propia infraestructura, garantizamos un rendimiento optimizado y una experiencia de usuario fluida. Esto significa que puede esperar tiempos de inferencia más rápidos y una mayor capacidad de procesamiento.
Sinergia con Flujos de Trabajo - Integración Simple
La integración de SAM Audio en su flujo de trabajo es rápida y sencilla, lo que le permite aumentar su productividad sin complicaciones. Esto es ideal para profesionales que buscan maximizar su tiempo y resultados.
Servicio Independiente - Soporte Dedicado
SAM Audio es un servicio independiente, lo que nos permite ofrecer un soporte dedicado y atención a cada uno de nuestros usuarios. No estamos afiliados a ningún proveedor de modelos, lo que nos hace mantener una postura neutral y centrada en el cliente.
Resolución de Problemas - Guías Útiles
Ofrecemos guías y artículos en nuestro blog para ayudar a resolver problemas comunes, como errores de CUDA o problemas de salida de audio. Esto asegura que nuestros usuarios siempre tengan acceso a soluciones rápidas y efectivas.
Licencia y Requisitos de Hardware - Acceso Claro
Proporcionamos información clara sobre los requisitos de GPU/VRAM y el acceso a pesos de SAM Audio. Lo que le permite hacer elecciones informadas sobre el hardware que necesita para lograr la mejor separación de audio posible.
Preguntas Frecuentes Sobre Sam Audio
¿Qué es SAM Audio y cómo funciona?
SAM Audio es un servicio independiente de separación de audio basado en inteligencia artificial que utiliza el Modelo de Segmentación de Todo de Meta. Este innovador sistema permite aislar voces, instrumentos, discursos y efectos de sonido de mezclas de audio complejas a través de comandos de texto, visuales o temporales. La tecnología puede aplicarse en diversas aplicaciones creativas y profesionales, facilitando tareas como la remasterización de música o la creación de podcasts.
¿Cuáles son los errores comunes que puedo encontrar al usar SAM Audio?
Algunos de los errores más comunes incluyen problemas con CUDA, que pueden surgir debido a la falta de compatibilidad de hardware, errores con FFmpeg, y dificultades asociadas con la falta de memoria o un rendimiento de separación deficiente. Para abordar estos problemas, se recomienda revisar los requisitos de hardware y asegurarse de que se cumplen todas las especificaciones necesarias.
¿Qué requisitos de GPU y licencia debo conocer antes de utilizar SAM Audio?
Es fundamental entender los requisitos de GPU y VRAM antes de desplegar SAM Audio. La plataforma opera en modelos con licencias Apache-2.0, lo que significa que los usuarios deben asegurarse de que cuentan con el hardware adecuado para ejecutar el sistema de manera eficiente. Además, se deben considerar las notas sobre el uso comercial, que podrían tener un impacto en cómo se pueden utilizar los resultados generados por el modelo.
¿Dónde puedo encontrar más información sobre las actualizaciones y características de SAM Audio?
En nuestro blog, ofrecemos artículos actualizados sobre las funcionalidades más recientes y noticias sobre el desarrollo del producto. La lectura continua de estas publicaciones puede ayudar a los usuarios a sacar el máximo provecho de SAM Audio y mantenerse al día con las innovaciones en la separación de audio.
¿SAM Audio es gratuito o tiene algún costo asociado?
SAM Audio es un servicio que puede requerir pago dependiendo de las características específicas y del uso comercial que los usuarios planean darle. Es recomendable revisar los detalles sobre la suscripción, si existe, y los costos potenciales relacionados con el acceso a funcionalidades premium o a modelos específicos.
¿Puedo usar SAM Audio para proyectos comerciales?
Sí, SAM Audio puede ser utilizado para proyectos comerciales siempre y cuando se cumplan con las condiciones de la licencia. Sin embargo, los usuarios deben estudiar detenidamente los requisitos relacionados con el uso de los modelos y los productos resultantes, para asegurarse de que cumplen con todas las normativas aplicables.
Cómo usar Sam Audio
Regístrate en SAM Audio
Crea una cuenta en SAM Audio proporcionando tu correo electrónico y estableciendo una contraseña segura. Asegúrate de verificar tu dirección de correo electrónico tras el registro.
Configura tu perfil
Accede a la sección de perfil para completar tu información personal. Esto incluye tu nombre, preferencias y ajustes de notificación.
Explora las funciones principales
Familiarízate con las capacidades de SAM Audio como la separación de audio, la isolación de voces y la extracción de efectos de sonido.
Sube tu archivo de audio
Haz clic en el botón de subir en el panel principal y selecciona el archivo que deseas procesar. Asegúrate de que tu archivo esté en un formato compatible.
Selecciona el tipo de separación
Elige qué elementos deseas separar, como voces, instrumentos, o efectos sonoros. Utiliza las opciones de prompts textuales o visuales según lo que necesites.
Inicia el proceso de separación
Haz clic en el botón de separación y espera a que SAM Audio procese tu archivo. La duración dependerá del tamaño y la complejidad del audio.
Descarga tus archivos separados
Una vez completado el proceso, se te proporcionará un enlace para descargar los archivos separados. Guarda los archivos en tu dispositivo para futuras ediciones.
Reseñas
Ventajas
- Fácil de usar
- Procesamiento rápido
- Excelentes resultados
- Precio asequible
Desventajas
- Versión gratuita limitada
- Requiere conexión a internet
Comentarios
Aún no hay comentarios. ¡Sé el primero en compartir tus ideas!
Sam Audio - Plataformas Alternativas
Para algunas alternativas de Sam Audio que puedas necesitar, te proporcionamos sitios divididos por características.

Voicemaker transforma texto en voz humana, permitiendo a los creadores producir locuciones fácilmente para diversas aplicaciones.
Esta página web ofrece un convertidor de audio en línea gratuito que admite más de 300 formatos, permitiendo a los usuarios convertir y extraer audio de archivos de video de forma segura.
Adobe Podcast ofrece herramientas impulsadas por inteligencia artificial para grabar, editar y mejorar audio de manera fluida en línea.
TurboScribe ofrece transcripción ilimitada de audio y video con características avanzadas como reconocimiento de hablantes, traducciones y alta precisión.