MakeHub
MakeHubは、APIリクエストをスマートにルーティングし、速度を最大化し、コストを最小化しながら、リアルタイムのパフォーマンス監視を提供します。
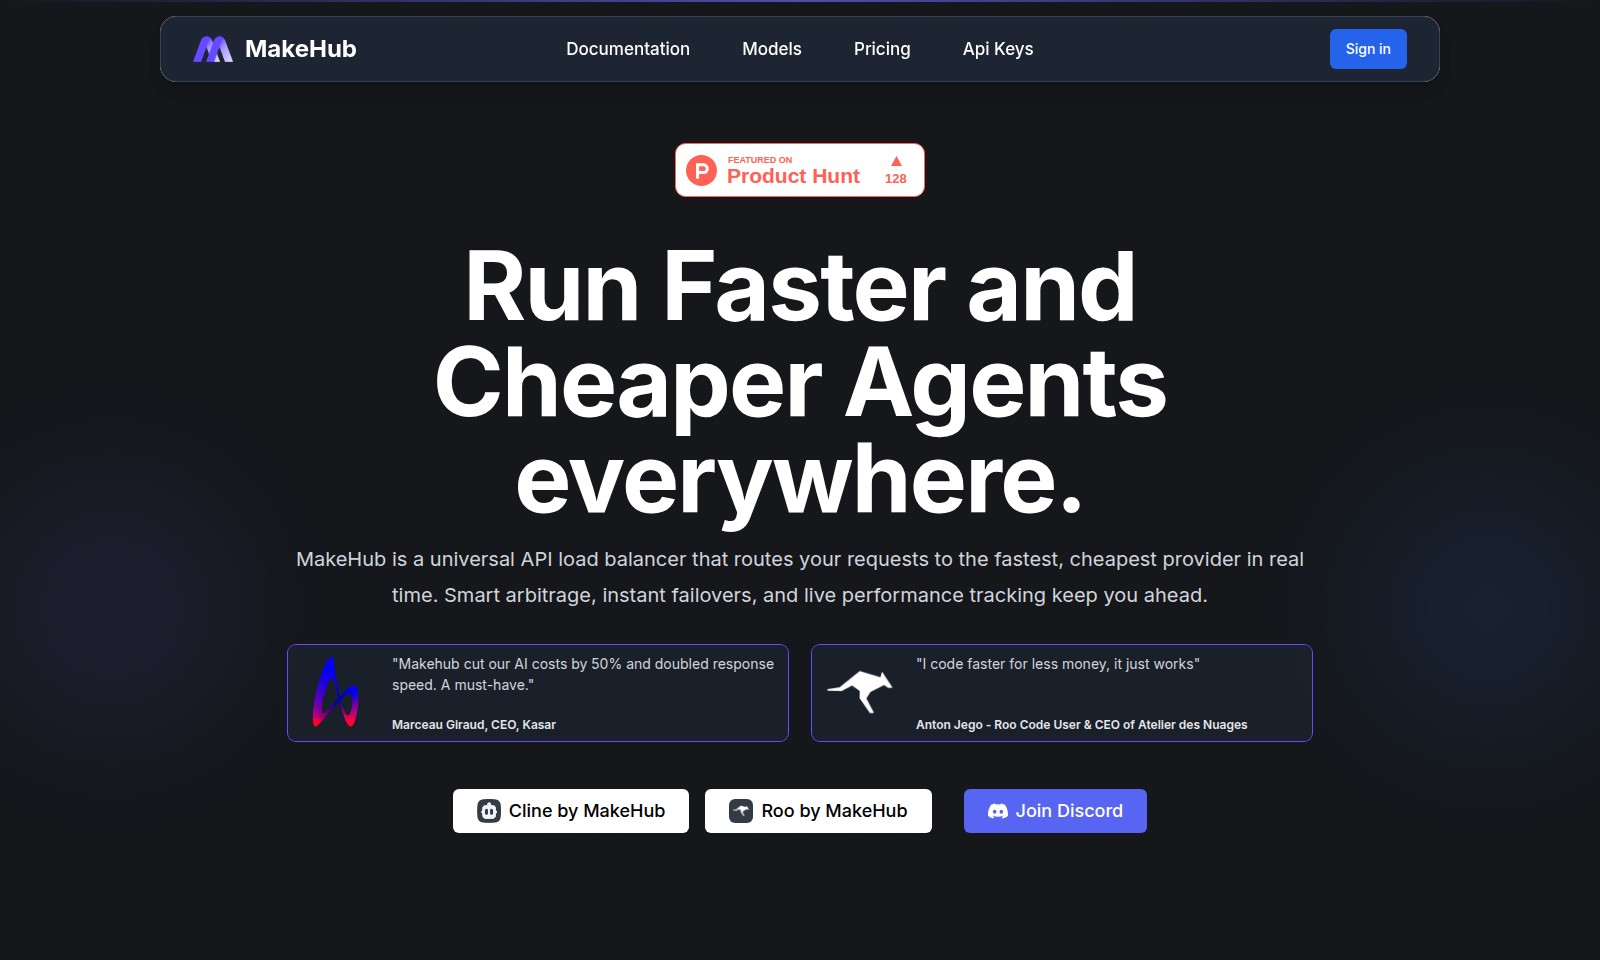
MakeHubの紹介
MakeHubによる効率的なAPI負荷分散
MakeHubは、リアルタイムでのリクエストルーティングを通じて、最も迅速でコスト効率の高いプロバイダーにリクエストを割り当てるユニバーサルAPI負荷分散ツールです。私たちのスマートなアービトラージ機能、即時のフェイルオーバー、そしてライブパフォーマンストラッキングにより、競争において常に先行することができます。
MakeHubの特徴
機能1 - 高速エージェントの実現
MakeHubを利用することで、ユーザーはリアルタイムで最も速く、安価なプロバイダーにリクエストをルーティングすることができ、AIのコストを50%削減し、応答速度を2倍にすることが可能です。
機能2 - インテリジェントプロバイダー経路設定
リアルタイムのパフォーマンスメトリクスに基づき、MakeHubは必要なモデルを選択することで、最適なプロバイダーに自動的にルーティングします。
機能3 - スマートアービトラージ
競争の激しい市場でも最高のコストパフォーマンスを実現。MakeHubを利用することで、エージェントをすばやく陳列し、ユーザーが最高の選択を即座に行えるようにします。
機能4 - インスタントフェイルオーバー
万が一のトラブルにも対応。MakeHubは、リアルタイムで障害を検知し、即座にバックアッププロバイダーに切り替えることができます。
機能5 - ライブパフォーマンストラッキング
MakeHubでは、各プロバイダーのパフォーマンスを常に追跡し、ユーザーに最良の選択肢を提供します。これにより、効果的なリソース配分が可能となります。
MakeHubに関するよくある質問
よくある質問(FAQ)
MakeHubとは何ですか?
MakeHubは、リアルタイムであなたのリクエストを最も速く、最も安価なプロバイダーにルーティングするユニバーサルAPIロードバランサーです。スマートアービトラージ、即時フェイルオーバー、ライブパフォーマンストラッキングにより、常に先を行くことができます。
どのようなAIプロバイダーがMakeHubと連携していますか?
MakeHubは、GCP、Anthropic、AWSなどの複数のAIプロバイダーと連携しています。これにより、最適なモデルを選択し、リアルタイムのパフォーマンスメトリクスに基づいて最適なプロバイダーにルーティングできます。
料金はどのように決まりますか?
MakeHubの料金は使用するリクエストの量と選択されたモデルによって異なります。具体的な料金については価格ページをご覧ください。
どのように設定すればよいのですか?
MakeHubの設定は簡単で、APIキーを取得し、提供されるドキュメントに従って簡単に接続できます。初めてのユーザー向けに詳細な設定ガイドも用意しています。
MakeHubのサポートはどのように受けられますか?
MakeHubでは、Discordコミュニティに参加することで他のユーザーと情報を共有したり、サポートを受けたりすることができます。また、公式なドキュメントも豊富に揃っています。
MakeHubはどんな業種に向いていますか?
MakeHubは、AIを使用するあらゆるビジネスや開発者に向いています。コスト削減およびパフォーマンス向上を目指す企業に特におすすめです。
MakeHubの使い方
アカウントを登録する
MakeHubのウェブサイトにアクセスし、「サインイン」ボタンをクリックしてください。必要な情報を入力し、アカウントを作成します。確認メールが届くので、リンクをクリックしてアカウントを有効化してください。
プロフィールを設定する
ログイン後、ダッシュボードに移動し、プロフィール設定を選択します。各項目を適切に入力し、保存ボタンをクリックして設定を完了させましょう。
APIキーを取得する
「APIキー」セクションに進み、新しいキーを生成します。このキーは、MakeHubの機能を実行するために必要ですので、安全に保管してください。
モデルを選択する
サポートされているAIモデルのリストから、利用したいモデルを選びます。Claude 4 Opus、GPT-4.1、Llama 4 Maverickからあなたの目的に最適なモデルを選択してください。
リクエストを送信する
ダッシュボードからリクエストを作成し、選択したモデルに基づいてクエリを入力します。これにより、MakeHubが最適なプロバイダーにリクエストをルーティングします。
結果を受け取る
リクエストを送信すると、MakeHubが最速かつ最安のプロバイダーからレスポンスを受け取ります。これを確認し、必要に応じて調整を行います。
フィードバックを提供する
得られた結果についてフィードバックを提供することで、今後の改善に役立てます。ダッシュボード内のフィードバックセクションから簡単に行えます。
レビュー
長所
- 使いやすい
- 処理が高速
- 優れた結果
- 手頃な価格
短所
- 無料版は機能制限あり
- インターネット接続が必要
コメント
まだコメントがありません。最初にあなたの考えをシェアしましょう!
MakeHub - 代替プラットフォーム
必要な MakeHub の代替案として、機能別に分類されたサイトを提供しています。
